5 dəqiqəyə oxunur
Embedding nədir: süni intellekt mənanı necə başa düşür
«Ucuz» sözü olmayan nəticələri axtarış sistemi necə tapır? Sözlərin rəqəmlərə çevrilməsini, kral − kişi + qadın fokusunu, RAG çat-botlarını və embedding-lərin harada ilişdiyini sadə dillə izah edirik.
Yaxşı bir axtarış sisteminə «Bakıda ucuz qalmaq üçün yer» yazın. Qarşınıza Fəvvarələr meydanının yanında hostel, İçərişəhərdə qonaq evi, bəlkə də bulvarın yaxınlığında büdcəli bir otel çıxacaq. Nəticələrə diqqətlə baxsanız, böyük ehtimalla heç birində «ucuz» sözü yoxdur. Heç kim öz elanına «ucuz» yazmır. «Sərfəli qiymət», «ekonom», «münasib» yazırlar, ya da sadəcə qiyməti göstərirlər.
Bəs axtarış sistemi bunu haradan bildi? O, sizin sözlərinizi yox, nə demək istədiyinizi tutdu. Bunu mümkün edən şeyin adı embeddingdir. Onu başa düşəndən sonra bu gün «süni intellekt» dediyimiz şeylərin yarısı artıq sehr kimi görünmür.
Söz rəqəmlər siyahısına çevrilir
Kompüter sözlərlə pis, rəqəmlərlə isə çox yaxşı işləyir. Embedding modeli mətni (bir sözü, cümləni, bütöv məhsul təsvirini) götürüb uzun bir rəqəm sırasına çevirir. Təxminən belə:
"pişik" → [0.021, -0.344, 0.187, 0.903, -0.052, ... ]Bu sırada adətən bir neçə yüzdən bir neçə minə qədər rəqəm olur. Açıq modellərdə çox vaxt 768, OpenAI-ın text-embedding-3-small modelində isə 1536. Onları bir-bir oxumaq mümkün deyil, buna ehtiyac da yoxdur: heç bir ayrıca rəqəm «heyvan» və ya «tüklü» demək deyil. Məna bütün sıranın içindədir.
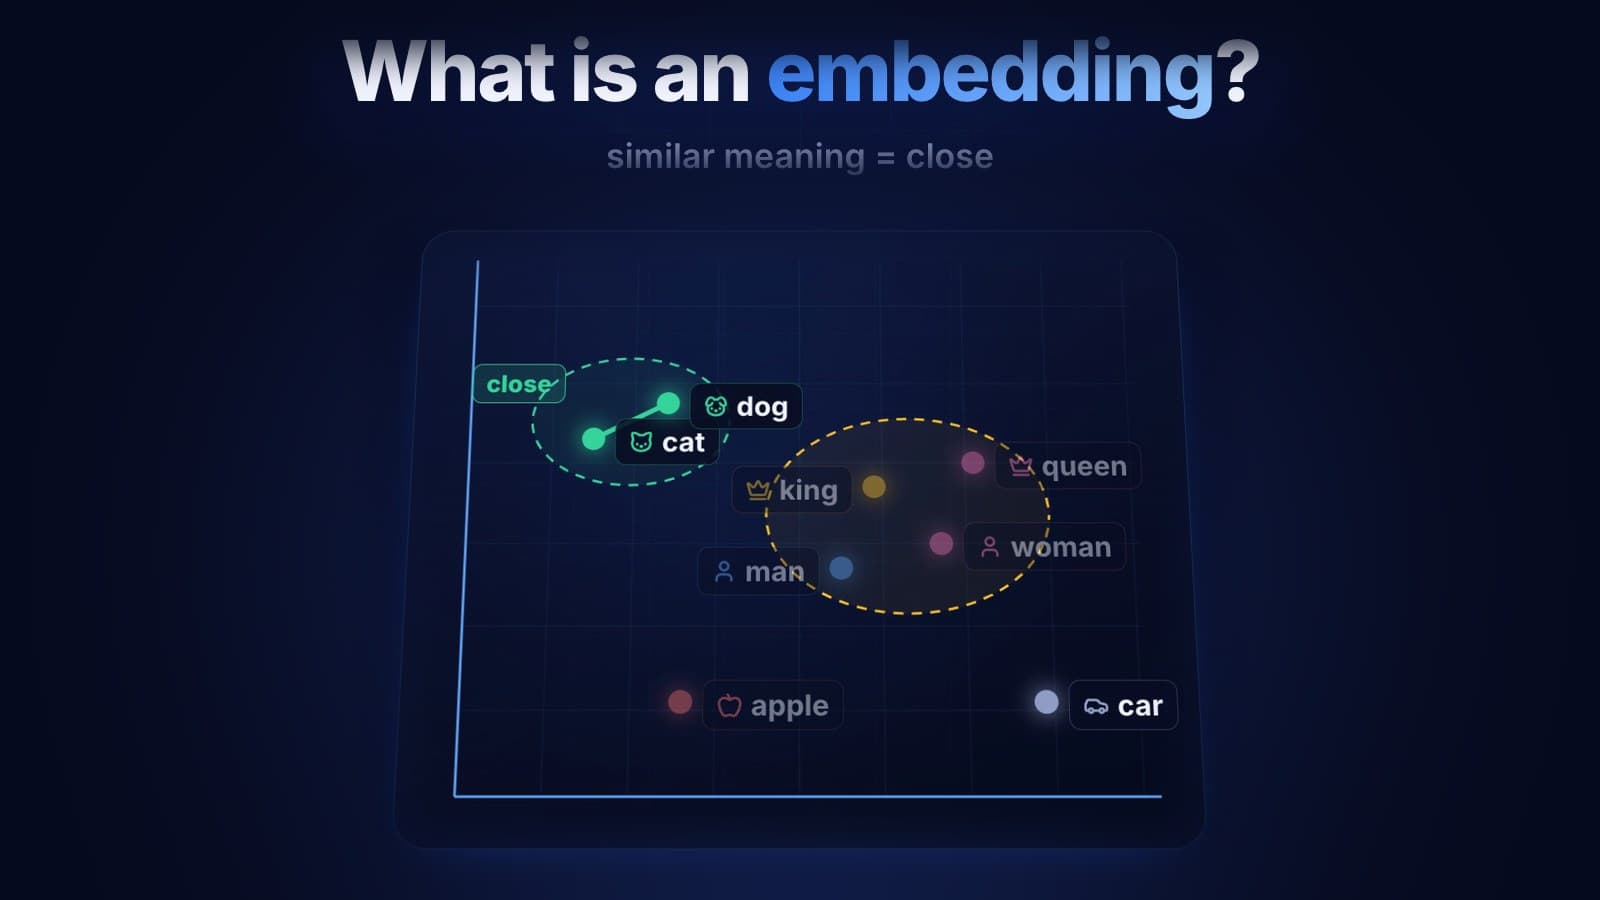
Bunu koordinat kimi təsəvvür etmək ən asandır. Xəritədəki nöqtənin iki koordinatı var: en dairəsi və uzunluq dairəsi. Embedding isə iki yox, 768 istiqaməti olan fəzada bir nöqtədir. Bunu gözümüzün önünə gətirə bilmirik, ona görə də yuxarıdakı videoda və demək olar ki, bütün izahlarda onu düz 2D şəklə salırlar. Bu sadələşdirmədir, amma faydalı sadələşdirmədir.
Oxşar məna — yaxın nöqtələr
İndi ən vacib hissə. Model nəhəng həcmdə mətn üzərində öyrədilir və oxşar kontekstlərdə işlənən sözləri bir-birinin yanına qoymağı öyrənir. «Pişiyi» də, «iti» də yedizdirirlər, ikisi də divanda yatır, ikisini də baytara aparırlar, ona görə də qonşu olurlar. «Maşını» isə park edirlər, ona benzin vururlar, onunla Heydər Əliyev prospektində tıxacda dayanırlar, deməli, o, tamam başqa yerə düşür.
Heç kim modelə pişik və itin ev heyvanı olduğunu deməyib. Model bunu insanların necə yazmasından özü çıxarıb. Bütün yanaşmanın həm gücü, həm də zəifliyi elə buradadır, buna hələ qayıdacağıq.
«Yaxınlıq» necə ölçülür
Elə gəlir ki, xətkeş götürüb iki nöqtə arasındakı məsafəni ölçmək bəs edər. Praktikada isə daha çox bucağa baxırlar: koordinat başlanğıcından hər nöqtəyə ox çəkir və bu oxların nə qədər fərqli istiqamətə baxdığını yoxlayırlar. Buna kosinus oxşarlığı deyilir.
Oxlar demək olar ki, eyni tərəfə baxır (kiçik bucaq) → nəticə 1-ə yaxın → məna oxşardır.
Oxlar düz bucaq altındadır → nəticə 0-a yaxın → mətnlər bir-biri ilə bağlı deyil.
Niyə məsafə yox, bucaq? Çünki vektorun uzunluğu çox vaxt bizə maraqlı olmayan şeyləri, məsələn, mətnin nə qədər uzun və sözçül olduğunu göstərir. Məna isə istiqamətdə yaşayır. «Dəhşətli xidmət» yazılmış qısa rəy də, eyni şeyi deyən uzun və hirsli abzas da eyni tərəfə baxmalıdır, hətta oxlardan biri daha uzun olsa belə.
Məşhur fokus: kral − kişi + qadın
2013-cü ildə Tomaş Mikolovun rəhbərlik etdiyi Google komandası word2vec-i təqdim etdi və onunla birlikdə o vaxtdan bəri süni intellektlə bağlı hər çıxışda görünən bir nümunəni. «Kral» vektorunu götürürük, «kişini» çıxırıq, «qadını» əlavə edirik və nəticəyə ən yaxın sözü axtarırıq. Alınır: «kraliça».
Bu ona görə işləyir ki, «kişidən» «qadına» gedən istiqamət təxminən «kraldan» «kraliçaya» gedən istiqamətlə eynidir. Model öz fəzasında bir növ «cins oxu» tapıb, halbuki onu heç kim təyin etməyib. Eyni şey ölkələr və paytaxtlar, fellərin zamanları və s. ilə də müşahidə olundu.
Kiçik bir dürüst qeyd: bu nümayişlərdə ilkin sözlər cavabdan çıxarılır. Bu qayda olmasa, «kral − kişi + qadın» nəticəsinə ən yaxın nöqtə çox vaxt elə «kralın» özü olur. Effekt realdır, amma slaydlarda göründüyü qədər təmiz deyil.
Yenə də əsas fikir doğrudur: məna həndəsəyə çevrilib, həndəsə ilə isə hesablamaq olar.
Bu, real həyatda harada işlədilir
Bu, sadəcə mühazirə mövzusu deyil. Son bir ildə aşağıdakılardan hər hansı birindən istifadə etmisinizsə, deməli, embedding-lərdən də istifadə etmisiniz.
Sizi başa düşən axtarış
Sistem sözlərin üst-üstə düşməsini axtarmaq əvəzinə sorğunuzu vektora çevirir və vektoru ən yaxın istiqamətə baxan sənədləri tapır. «Ucuz qalmaq üçün yer» sorğusu «ekonom qonaq evi»ni, «tələbə üçün noutbuk» isə 1000 manatdan ucuz yüngül noutbuku belə tapır, halbuki onların ortaq sözü yoxdur.
Tövsiyələr
«Bu məhsula baxanlar bunlara da baxıb…» blokunu məhsulları, məqalələri və ya filmləri eyni fəzaya yerləşdirib qonşularını təklif etməklə qurmaq olar. Onlayn mağazanın tövsiyə verməyə başlaması üçün bir illik satış tarixçəsi lazım deyil: başlanğıc üçün təsvirlər kifayətdir.
Biznesinizi tanıyan çat-botlar (RAG)
Şirkətə öz sənədləri (qiymət siyahıları, qaydalar, müqavilələr) əsasında cavab verən çat-bot lazım olanda adətən RAG, yəni retrieval-augmented generation istifadə olunur. Bütün sənədlər bir dəfə hissələrə bölünür və embedding-ə çevrilir. Müştəri sual verəndə sual da vektora çevrilir, ən yaxın hissələr seçilir və dil modelinə yalnız onlar ötürülür. Modelin şirkətinizi «yadda saxlamasına» ehtiyac yoxdur: o, sadəcə lazımi anda lazımi səhifəni oxuyur.
Kodda bu necə görünür
Səsləndiyi qədər qorxulu deyil. Layihəniz artıq Postgres üzərində işləyirsə (Supabase də daxil olmaqla), pgvector genişlənməsi embedding-ləri adi məlumatlarınızın yanında saxlamağa imkan verir. Ən oxşar beş məhsulu tapmaq bir sorğudur:
select title, price
from products
order by embedding <=> $1
limit 5;
Burada $1 istifadəçi sorğusunun embedding-i, <=> isə kosinus məsafəsidir. Kiçik və orta layihələrin əksəriyyəti üçün ayrıca vektor bazasına ehtiyac yoxdur.
Üstəlik, bu, ucuzdur. On min məhsuldan ibarət kataloqu bulud modeli ilə embedding-ə çevirmək adətən bir fincan qəhvədən də ucuz başa gəlir və bu, bir dəfə edilir. Sonra yalnız dəyişən məhsullar yenidən hesablanır.
Embedding-lər harada ilişir
Bu texnologiyanı çox sevirik, elə buna görə də onun məhdudiyyətləri barədə açıq danışmaq lazımdır:
Dəqiq şeylər. Artikullar, telefon nömrələri, hesab-faktura nömrələri, «iPhone 15» və «iPhone 16» kimi model adları. Məna baxımından onlar demək olar ki, eynidir və təmiz vektor axtarışı onları asanlıqla qarışdırır. Burada adi söz axtarışı daha yaxşı işləyir.
İnkar. «Hovuzlu otel» və «hovuzsuz otel» vektor fəzasında bir-birinə çox yaxındır. Model eyni mövzunu görür və mənanı tərsinə çevirən yeganə hissəni gözdən qaçırır.
Dil. Bir çox model əsasən ingilis dilində öyrədilib. Yaxşı çoxdilli modellər Azərbaycan və rus dilinin öhdəsindən gəlir, amma keyfiyyət çox fərqlənir. Seçməzdən əvvəl öz real məlumatlarınızda yoxlayın.
Bölmə. RAG-da sənədləri necə hissələrə böldüyünüz modelin özü qədər vacibdir. Qiymət cədvəlini ortadan bölün, çat-bot inamla səhv qiyməti deyəcək.
Ona görə də real layihələrdə nadir hallarda yalnız vektorlardan istifadə edirik. Adi sxem hibrid axtarışdır: söz axtarışı və vektor axtarışı paralel işləyir, nəticələr birləşdirilir. Dəqiq uyğunluqlar dəqiq qalır, qeyri-müəyyən sorğular isə yenə də insanların nə demək istədiyini tapır.
Bir cümlə ilə
Embedding rəqəmlərə çevrilmiş mənadır ki, «oxşarlıq» kompüterin ölçə biləcəyi bir şey olsun. Müasir axtarışda, tövsiyələrdə və biznes çat-botlarında ağıllı görünən demək olar ki, hər şey bu bir ideyanın üzərində qurulub.
Mağazanız üçün ağıllı axtarış, öz sənədləriniz əsasında cavab verən çat-bot barədə düşünürsünüzsə və ya sadəcə biznesinizə süni intellektin ümumiyyətlə lazım olub-olmadığını bilmək istəyirsinizsə, süni intellekt inteqrasiyası üzrə nə etdiyimizə baxın və ya bizə yazın. Əgər tapşırığın öhdəsindən adi filtr daha yaxşı gələcəksə, bunu da açıq deyəcəyik.