6 мин чтения
Что такое эмбеддинг: как ИИ понимает смысл
Как поиск находит результаты, в которых нет слова из запроса? Простыми словами о том, как слова становятся числами, о фокусе «король − мужчина + женщина», RAG-чат-ботах и о том, где эмбеддинги подводят.
Введите в хороший поиск «недорогое жильё в Баку», и он покажет хостел у Фонтанной площади, гостевой дом в Ичеришехер, какой-нибудь бюджетный отель у бульвара. Присмотритесь к выдаче: скорее всего, слова «недорогое» там нет ни в одном объявлении. Никто так не пишет о себе. Пишут «доступные цены», «эконом», «выгодно» или просто указывают цену.
Как же поиск догадался? Он сравнивал не ваши слова, а то, что вы имели в виду. Делает это возможным штука под названием эмбеддинг. Разберётесь с ней, и половина того, что сейчас называют «искусственным интеллектом», перестанет казаться магией.
Слово превращается в список чисел
Со словами компьютер работает плохо, с числами — отлично. Модель эмбеддингов берёт кусок текста (слово, предложение, целое описание товара) и превращает его в длинный ряд чисел. Примерно так:
"кот" → [0.021, -0.344, 0.187, 0.903, -0.052, ... ]Чисел в таком ряду обычно от нескольких сотен до нескольких тысяч. У открытых моделей часто 768, у text-embedding-3-small от OpenAI — 1536. Прочитать их по одному не получится, и не нужно: ни одно отдельное число не означает «животное» или «пушистый». Смысл несёт весь ряд целиком.
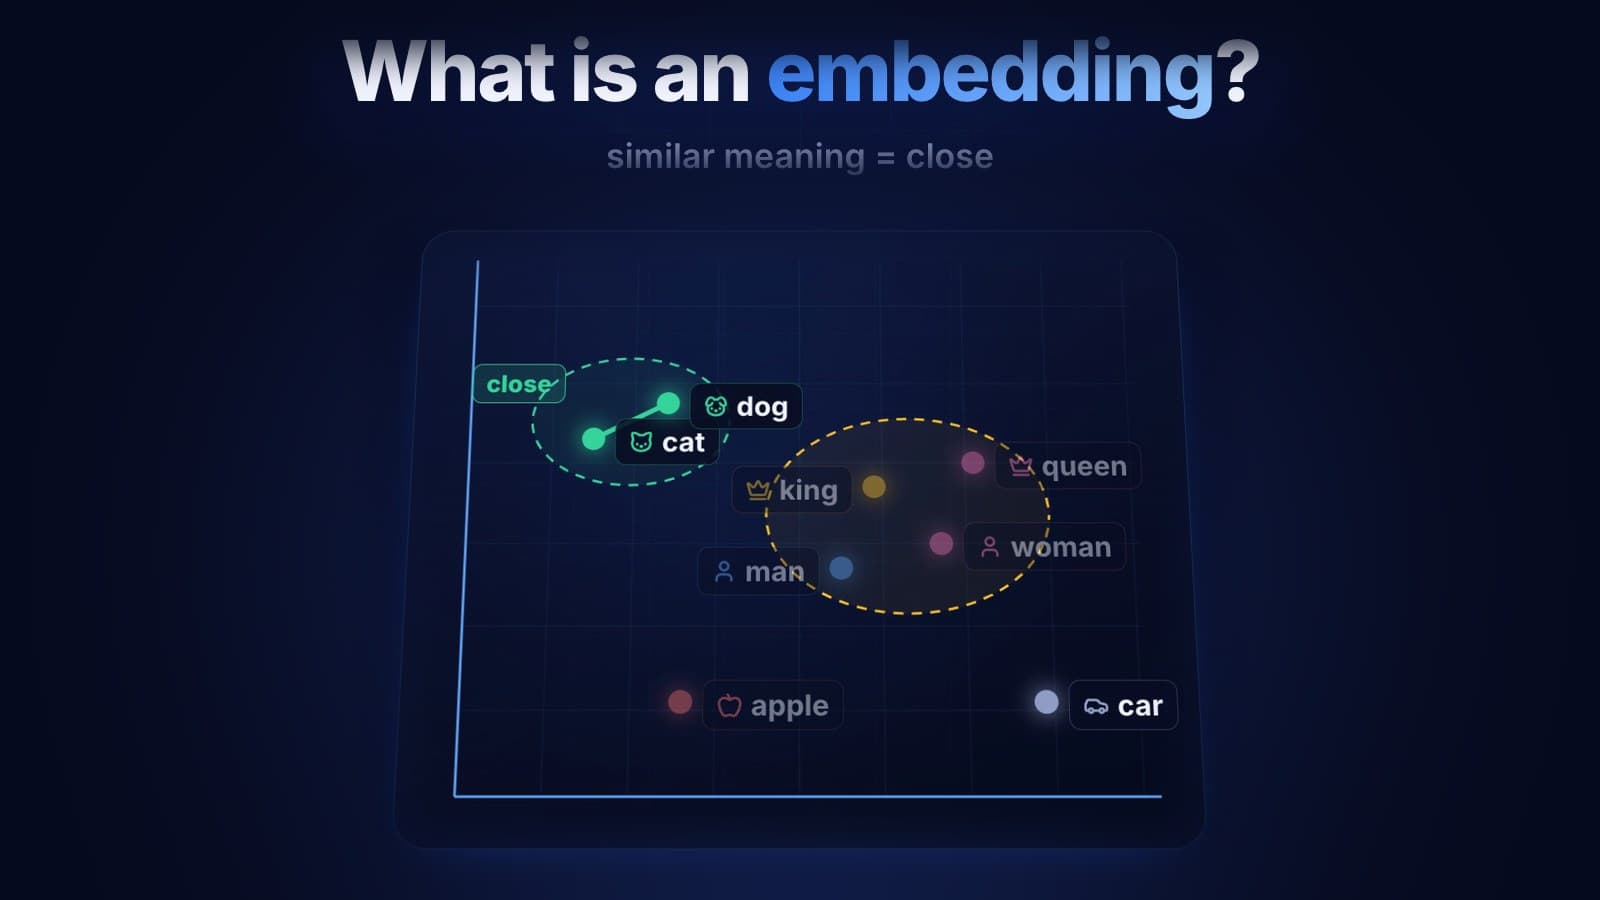
Проще всего думать о нём как о координатах. У точки на карте их две: широта и долгота. Эмбеддинг — это точка в пространстве, где направлений не два, а 768. Представить такое нельзя, поэтому в видео выше и почти во всех объяснениях его сплющивают до плоской 2D-картинки. Это упрощение, но полезное.
Близкий смысл — близкие точки
Теперь главное. Модель обучают на огромном количестве текста, и она учится ставить рядом слова, которые встречаются в похожих контекстах. «Кота» и «собаку» кормят, они спят на диване, их водят к ветеринару, поэтому они оказываются по соседству. «Машину» паркуют, заправляют и с ней стоят в пробке на проспекте Гейдара Алиева, так что она оказывается совсем в другом месте.
Никто не объяснял модели, что кошки и собаки — домашние животные. Она вычислила это сама, по тому, как пишут люди. В этом и сила, и слабость всего подхода, к этому мы ещё вернёмся.
Как измеряют «близость»
Казалось бы, можно просто взять линейку и измерить расстояние между точками. На практике чаще смотрят на угол: проводят стрелку от начала координат к каждой точке и смотрят, насколько по-разному они направлены. Это называется косинусное сходство.
Стрелки смотрят почти в одну сторону (маленький угол) → оценка близка к 1 → смысл похож.
Стрелки под прямым углом → оценка около 0 → тексты не связаны.
Почему угол, а не расстояние? Длина вектора часто отражает то, что нам неинтересно, например, насколько длинным и многословным был текст. А смысл живёт в направлении. Короткий отзыв «ужасный сервис» и длинный злой абзац о том же самом должны смотреть в одну сторону, даже если одна стрелка длиннее.
Знаменитый фокус: король − мужчина + женщина
В 2013 году команда Google во главе с Томашем Миколовым выпустила word2vec, а вместе с ним пример, который с тех пор есть в каждом докладе про ИИ. Берём вектор «король», вычитаем «мужчину», прибавляем «женщину» и ищем ближайшее слово к результату. Получается «королева».
Работает это потому, что направление от «мужчины» к «женщине» примерно такое же, как от «короля» к «королеве». Модель нашла в своём пространстве что-то вроде «оси пола», хотя её никто не задавал. То же самое обнаружилось у стран и столиц, у времён глаголов и так далее.
Честная сноска: в таких демонстрациях исходные слова исключают из ответа. Без этого правила ближайшей точкой к «король − мужчина + женщина» часто оказывается сам «король». Эффект настоящий, но не такой чистый, как на слайдах.
И всё же суть верна: смысл стал геометрией, а с геометрией можно считать.
Где это используется на самом деле
Это не просто тема для лекции. Если за последний год вы пользовались чем-то из списка ниже, вы пользовались эмбеддингами.
Поиск, который вас понимает
Вместо поиска совпадающих слов система превращает запрос в вектор и ищет документы, чьи векторы смотрят в ту же сторону. Так «недорогое жильё» находит «эконом гостевой дом», а «ноутбук для студента» находит лёгкий ноутбук дешевле 1000 манатов, хотя общих слов у них нет.
Рекомендации
«С этим товаром также смотрят…» можно сделать, поместив товары, статьи или фильмы в одно пространство и предлагая соседей. Интернет-магазину не нужен год истории покупок, чтобы начать рекомендовать: для старта хватит описаний.
Чат-боты, которые знают ваш бизнес (RAG)
Когда компании нужен чат-бот, который отвечает по её собственным документам (прайсам, правилам, договорам), обычно используют RAG, retrieval-augmented generation. Все документы один раз режут на фрагменты и превращают в эмбеддинги. Когда клиент задаёт вопрос, его тоже превращают в вектор, достают самые близкие фрагменты и передают языковой модели только их. Модели не нужно «помнить» вашу компанию: она просто читает нужную страницу в нужный момент.
Как это выглядит в коде
Не так страшно, как звучит. Если проект уже работает на Postgres (в том числе на Supabase), расширение pgvector позволяет хранить эмбеддинги прямо рядом с обычными данными. Найти пять самых похожих товаров можно одним запросом:
select title, price
from products
order by embedding <=> $1
limit 5;
Здесь $1 — эмбеддинг запроса пользователя, а <=> — косинусное расстояние. Для большинства небольших и средних проектов отдельная векторная база не нужна.
И это дёшево. Перевести в эмбеддинги каталог из десяти тысяч товаров через облачную модель обычно стоит дешевле чашки кофе, и делается это один раз. Потом пересчитываются только изменившиеся товары.
Где эмбеддинги подводят
Нам эта технология очень нравится, и именно поэтому стоит честно сказать о её ограничениях:
Точные вещи. Артикулы, телефоны, номера счетов, названия моделей вроде «iPhone 15» и «iPhone 16». По смыслу они почти одинаковые, и чистый векторный поиск легко их путает. Тут обычный поиск по словам работает лучше.
Отрицание. «Отель с бассейном» и «отель без бассейна» в векторном пространстве стоят совсем рядом. Модель видит одну и ту же тему и не замечает единственное слово, которое переворачивает смысл.
Язык. Многие модели учились в основном на английском. С азербайджанским и русским хорошие мультиязычные модели справляются, но качество сильно разнится. Проверяйте на своих реальных данных, прежде чем выбирать.
Нарезка. В RAG то, как вы режете документы, важно не меньше самой модели. Разрежьте прайс-таблицу пополам, и чат-бот уверенно назовёт не ту цену.
Поэтому в реальных проектах мы редко используем одни только векторы. Обычная схема — гибридный поиск: поиск по словам и векторный поиск работают параллельно, а результаты объединяются. Точные совпадения остаются точными, а размытые запросы всё равно находят то, что люди имели в виду.
Если одной фразой
Эмбеддинг — это смысл, переведённый в числа, чтобы «похожесть» стала тем, что компьютер может измерить. Почти всё, что кажется умным в современном поиске, рекомендациях и бизнес-чат-ботах, стоит на этой одной идее.
Если вы думаете об умном поиске для магазина, о чат-боте, который отвечает по вашим документам, или просто хотите понять, нужен ли вашему бизнесу ИИ вообще, посмотрите, что мы делаем в интеграции ИИ или напишите нам. Мы честно скажем, если с задачей лучше справится обычный фильтр.